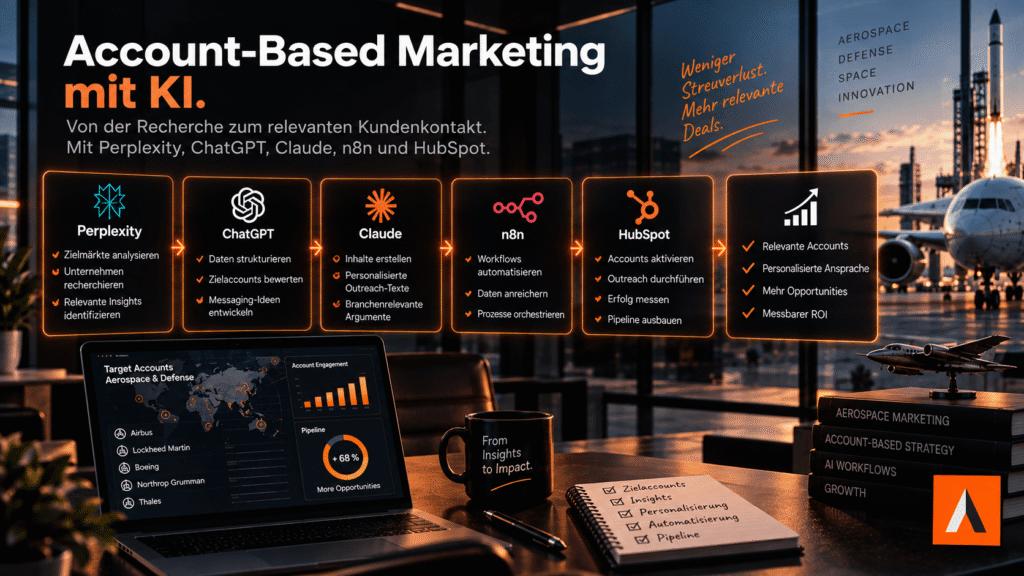
Kurz gefasst. Account-Based Marketing lebt von Recherche, und genau die hat ABM bisher teuer gemacht. Ich habe mit Perplexity getestet, wie weit KI-Recherche in einer der schwierigsten B2B-Branchen trägt: der Luft- und Raumfahrt. Aus einem halben Tag pro Account wurden rund 45 Minuten, alles im Pro-Tarif. Die Schwachstellen liegen bei Mittelständlern, Konzernverflechtungen und Personenangaben. Dazu zeige ich, wie ich daraus im Unternehmen einen agentischen Workflow mit HubSpot, Claude, ChatGPT und n8n bauen würde, mit einem menschlichen Gate an jeder kritischen Stelle.
Datum: August bis September 2026 · Setup: privater Perplexity-Pro-Account mit Space (Softwarebeschreibung, drei Referenzfälle, ICP-Profil, Rechercheregeln), stichprobenartiger Kontrollabgleich auf LinkedIn · Werkzeuge: Perplexity (Spaces, Deep Research, geplante Aufgaben, Model Council über Perplexity Computer), LinkedIn · Zeitaufwand: rund 45 Minuten pro Account, 12 Accounts · Ergebnis: 12 einseitige Account-Dossiers plus Konzept für einen agentischen ABM-Workflow · Was nicht funktioniert hat: Signale bei Mittelständlern, Zuordnung von Konzerngesellschaften, aktuelle Personenangaben, die Neigung zur Bestätigung von Hypothesen
Wie erkennst du, wann ein Flugzeughersteller über neue Software sprechen will?
In kaum einer Branche ist das schwerer. Die Verkaufszyklen dauern ein bis zwei Jahre, das Buying Center ist groß, und vieles, was relevant wäre, steht in keiner Pressemitteilung.
Genau deshalb habe ich Perplexity in diesem Umfeld getestet. Meine Frage: Wie weit trägt KI-Recherche im Account-Based Marketing, und wo braucht es weiterhin den Menschen?
Vorher kurz zu den Grundlagen. Wer ABM oder Perplexity schon kennt, springt direkt zum Testaufbau.
Was ist Account-Based Marketing?
Account-Based Marketing, kurz ABM, dreht den klassischen Marketing-Trichter um. Statt möglichst viele Kontakte einzusammeln und daraus die guten herauszufiltern, legst du zuerst fest, welche Unternehmen du gewinnen willst. Danach sprechen Marketing und Vertrieb genau diese Unternehmen gemeinsam und individuell an.
Ein Account ist dabei nicht eine Person, sondern das ganze Unternehmen mit allen Menschen, die an einer Kaufentscheidung beteiligt sind.
Wofür ist ABM gut?
ABM spielt seine Stärken aus, wenn drei Dinge zusammenkommen: wenige mögliche Kunden, hohe Auftragswerte und komplexe Entscheidungen mit vielen Beteiligten. Typisch für erklärungsbedürftige B2B-Lösungen, Industriesoftware oder IT-Dienstleistungen.
In so einem Markt produziert breite Leadgenerierung vor allem Streuverluste. Hundert Whitepaper-Downloads helfen wenig, wenn der eine Konzern, der zählt, nicht darunter ist.
ABM sorgt außerdem dafür, dass Marketing und Vertrieb dieselbe Liste im Blick haben. Das klingt banal. In vielen Unternehmen ist genau das der größte Hebel.
Wie unterscheidet sich ABM von Lead Generation und Demand Generation?
| Lead Generation | Demand Generation | Account-Based Marketing | |
|---|---|---|---|
| Ziel | Kontakte sammeln und qualifizieren | Nachfrage und Problembewusstsein im Markt aufbauen | Ausgewählte Unternehmen gezielt gewinnen |
| Startpunkt | Breiter Markt | Breiter Markt | Feste Liste von Zielaccounts |
| Typische Mittel | Gated Content, Formulare, Webinare | Ungated Content, Thought Leadership, Community | Individuelle Botschaften, gezielte Anzeigen, persönliche Ansprache |
| Erfolg gemessen an | Anzahl und Qualität der Leads | Reichweite, Markenwahrnehmung, Pipeline-Einfluss | Engagement im Account, Pipeline, gewonnene Deals |
| Rolle des Vertriebs | Übernimmt qualifizierte Leads | Profitiert indirekt | Arbeitet von Anfang an mit |
Die drei Ansätze schließen sich nicht aus. Demand Generation sorgt dafür, dass dein Thema im Markt bekannt ist. ABM sorgt dafür, dass die richtigen Unternehmen es von dir hören.
Warum ist ABM so aufwendig?
Der Engpass war schon immer die Recherche. Gutes ABM braucht für jeden Account ein Verständnis von Strategie, aktuellen Anlässen und Entscheidungsstrukturen. Bei zwanzig Zielaccounts ist das ein Vollzeitjob.
Genau hier setzt KI-Recherche an. Deshalb dieser Test.
Was ist Perplexity, und was unterscheidet es von ChatGPT oder Claude?
Perplexity ist eine KI-Antwortmaschine mit Echtzeit-Websuche. Jede Antwort kommt mit Quellenangaben, die du direkt öffnen und prüfen kannst. Das macht Perplexity zum Spezialisten für Recherche, während ChatGPT oder Claude ihre Stärken eher beim Denken, Schreiben und Bauen haben.
Mein Homebase-Modell bleibt Claude. Für Recherche greife ich zu Perplexity. Wie sich die Werkzeuge in meinem Alltag aufteilen, steht im Überblick über den agentischen Marketing-Stack.
Im Test habe ich vier Funktionen genutzt:
Spaces. Ein Arbeitsbereich, in dem Dateien und feste Anweisungen liegen. Jede Recherche im Space kennt diesen Kontext, ohne dass ich ihn jedes Mal neu erklären muss.
Deep Research. Der Tiefenrecherche-Modus. Perplexity sucht dabei iterativ, liest Dokumente und passt seinen Rechercheplan an, während es mehr über das Thema lernt. Am Ende steht ein Bericht mit Quellen.
Geplante Aufgaben. Wiederkehrende Suchen, die automatisch laufen. Ideal für einen regelmäßigen Signal-Scan.
Model Council. Dieselbe Frage läuft parallel durch mehrere KI-Modelle, danach entsteht eine gemeinsame Antwort. Die Synthese zeigt, wo die Modelle übereinstimmen und wo sie sich widersprechen. Für meinen privaten Test hatte ich den Pro-Tarif. Dort läuft der Council über Perplexity Computer und verbraucht Credits, weil jedes Modell separat recherchiert. Im Unternehmen würde ich ohnehin einen Enterprise-Tarif nutzen. In Enterprise Max ist der Council im Web enthalten, mit einem monatlichen Kontingent statt Credits pro Lauf. Dazu kommt der wichtigere Grund: Nur die Enterprise-Tarife schließen aus, dass eure Daten zum Training genutzt werden.
Was habe ich getestet und was nicht?
Kurz vorweg, damit du den Bericht richtig einordnen kannst.
Getestet habe ich den kompletten Rechercheteil mit Perplexity, und zwar ausführlich. Alles, was danach kommt, also CRM, Kampagnen und Übergabe an den Vertrieb, habe ich bewusst nicht praktisch umgesetzt. Diese Plattform ist privat, und ich arbeite hier grundsätzlich nicht mit Unternehmensdaten oder Unternehmenssystemen.
Den zweiten Teil beschreibe ich deshalb als das, was er ist: die nächsten Schritte, wie ich sie in einem Unternehmen aufsetzen würde.
Wie sah das Testszenario aus?
Für den Test habe ich einen fiktiven Softwarehersteller angenommen. Er bietet eine Lösung für Konfigurations- und Compliance-Management in der Luft- und Raumfahrt an. Die Software dokumentiert über den gesamten Lebenszyklus eines Bauteils, welche Version wo verbaut ist und ob alle Nachweise für Zulassung und Qualitätsnormen vorliegen.
Das ist ein klassischer Fall für ABM. Die Zahl möglicher Kunden ist überschaubar, jeder Deal ist groß, und breite Leadgenerierung würde vor allem Streuverluste produzieren.
Als Zielaccounts habe ich reale, öffentlich dokumentierte Unternehmen genutzt, im Bericht anonymisiert. Insgesamt zwölf, vier pro Segment:
- Große Hersteller und Systemlieferanten mit viel öffentlicher Information
- Mittelständische Zulieferer mit wenig öffentlicher Präsenz
- Instandhaltungsbetriebe und New-Space-Unternehmen mit schnell wechselnden Strukturen
Im Folgenden heißen sie Account A bis L.
Wie war der Test aufgebaut?
Alles lief in einem Perplexity Space. Dort lagen vier Dinge: eine Beschreibung der fiktiven Software, drei ausgedachte Referenzfälle, das Profil der idealen Zielkunden und klare Rechercheregeln.
Die Regeln waren der wichtigste Teil. Jede Aussage braucht eine Quelle mit Datum. Quellen älter als 18 Monate zählen nicht. Kennzahlen immer mit Geschäftsjahr und Gesellschaft. Personen nur mit Funktion und aktueller Primärquelle, keine privaten Informationen.
Getestet habe ich von August bis September 2026 mit einem privaten Pro-Account. Die Recherchen liefen weitgehend automatisch als geplante Aufgaben. Zwischendurch habe ich immer wieder stichprobenartig auf LinkedIn gegengeprüft, ob die Daten stimmen, die Perplexity gefunden hat. Diesen Kontrollabgleich kann ich jedem nur empfehlen, der so einen Workflow aufsetzt.
Getestet habe ich sechs Schritte, die zusammen den Rechercheteil eines ABM-Prozesses abbilden. Die menschlichen Entscheidungen, die im Unternehmen Vertrieb und Account-Owner treffen würden, habe ich selbst übernommen.
Die Zahlen in diesem Bericht sind gerundete Erfahrungswerte aus dem Test, keine exakte Messreihe.
Test 1: Der Signal-Scan
Perplexity sollte als geplante Aufgabe automatisch nach Anlässen suchen, die auf Bedarf hindeuten. In der Luft- und Raumfahrt sind das zum Beispiel neue Flugzeugprogramme, höhere Produktionsraten, Übernahmen, neue Führungskräfte in Engineering oder Qualität, Förderprojekte und Stellenanzeigen für Configuration Manager oder PLM-Spezialisten.
Was gut funktioniert hat: Bei den großen Herstellern kamen zuverlässig brauchbare Anlässe. Produktionshochläufe und Programmankündigungen hat Perplexity schnell erkannt und korrekt eingeordnet.
Wo es gehakt hat: Bei den Konzernen kam zu viel. Jede Pressemitteilung wurde zum Signal, auch Themen ohne Bezug zur Software. Bei den Mittelständlern kam dagegen fast nichts. Drei von vier lieferten im ersten Durchlauf kein verwertbares Signal.
Was ich angepasst habe: Für Konzerne einen Relevanzfilter. Gemeldet wird nur, was Engineering, Qualität, Zulassung oder IT betrifft, jeweils mit Einschätzung hoch, mittel oder niedrig. Für den Mittelstand habe ich die Quellen erweitert: Jahresabschlüsse im Bundesanzeiger, Karriereseiten, regionale Wirtschaftspresse, Branchenverbände und Ausstellerlisten von Fachmessen.
Ergebnis: Vorher war etwa ein Drittel der gemeldeten Signale relevant, danach rund zwei Drittel.
Test 2: Der Rechercheplan
Vor jeder Tiefenrecherche erstellt Perplexity einen Rechercheplan. Den habe ich jedes Mal geprüft und freigegeben oder korrigiert.
Was gut funktioniert hat: Fehler wurden sichtbar, bevor Zeit und Credits draufgingen. Ein Blick auf den Plan reichte, um zu sehen, ob Perplexity die richtige Gesellschaft und die richtigen Fragen im Blick hatte.
Wo es gehakt hat: Die Branche ist voller Konzernverflechtungen, Joint Ventures und Programmgesellschaften. Bei vier von zwölf Accounts plante Perplexity zunächst eine Recherche zur falschen Einheit, meist zur Muttergesellschaft statt zum eigentlichen Standort.
Was ich angepasst habe: Im Plan muss die genaue Firmierung stehen, dazu die Einordnung in die Konzernstruktur. Stimmt die nicht, gebe ich den Plan nicht frei.
Ergebnis: Die Planprüfung hat pro Account rund zwei Minuten gekostet und war der wirksamste Hebel im gesamten Test. Zwei Minuten am Anfang ersparen viel Korrekturarbeit am Ende.
Test 3: Das Account-Dossier
Aus der freigegebenen Recherche sollte ein Dossier entstehen: Kurzprofil, strategische Prioritäten, aktuelle Anlässe, Hypothesen zum Bedarf und Anknüpfungspunkte zur Software.
Was gut funktioniert hat: Ein Dossier war in rund 15 Minuten fertig. Geschäftsberichte, Interviews, Programmmeldungen und Stellenanzeigen hat Perplexity sauber und mit nachvollziehbaren Quellen verdichtet. Besonders stark war die Verbindung von Stellenanzeigen mit strategischen Aussagen. Wenn ein Unternehmen die Produktionsrate erhöhen will und gleichzeitig mehrere Stellen im Konfigurationsmanagement ausschreibt, ist das ein ziemlich deutlicher Hinweis.
Wo es gehakt hat: Drei Fehlerbilder tauchten wiederholt auf. Kennzahlen aus verschiedenen Geschäftsjahren oder Konzernebenen wurden vermischt. Fachbegriffe aus Zulassung und Instandhaltung wurden teilweise verwechselt, was in dieser Branche sofort auffällt. Außerdem waren die ersten Dossiers mit fünf bis sechs Seiten viel zu lang für den Vertriebsalltag.
Was ich angepasst habe: Maximal eine Seite, feste Gliederung, Kennzahlen nur mit Jahr und Gesellschaft. Für die Fachbegriffe kam ein kurzes Glossar in den Space.
Ergebnis: Die Korrekturen pro Dossier sanken von fünf bis sechs auf ein bis zwei.
Test 4: Das Buying Center
In der Luft- und Raumfahrt entscheidet selten eine Person allein. Typisch beteiligt sind Engineering, Qualität und Zulassung, IT beziehungsweise PLM, die Programmleitung und der Einkauf.
Was gut funktioniert hat: Die Rollen und ihre typischen Interessen hat Perplexity treffend abgeleitet. Qualität denkt an Audits und Nachweise, Engineering an Änderungsprozesse, IT an Integration in bestehende Systeme.
Wo es gehakt hat: Konkrete Personen waren die größte Schwachstelle. Drei von zehn genannten Führungskräften waren laut meinem Kontrollabgleich auf LinkedIn nicht mehr in der genannten Position. Zudem ist gerade im Verteidigungsumfeld vieles bewusst nicht öffentlich.
Was ich angepasst habe: Das Dossier nennt nur noch Funktionen mit Quelle. Wer konkret dahintersteckt, ist Aufgabe des Menschen, der den Account betreut.
Test 5: Die Gegenprüfung
Dieser Test brachte die überraschendste Erkenntnis.
Wo es gehakt hat: Perplexity bestätigt gerne, was im Prompt steht. Die Frage „Welche Hinweise gibt es, dass Account C Schwierigkeiten mit der Nachverfolgbarkeit seiner Bauteile hat?“ lieferte Hinweise, auch wenn sie dünn waren.
Was ich getestet habe: Dieselbe Hypothese habe ich zusätzlich kritisch formuliert: „Welche Belege sprechen dagegen? Gibt es Hinweise, dass das Thema gelöst ist oder ein anderer Anbieter im Einsatz ist?“ Bei wichtigen Accounts habe ich außerdem den Model Council genutzt. Im Pro-Tarif kostet jeder Lauf Credits, deshalb bewusst nur dort, wo viel auf dem Spiel stand.
Ergebnis: Bei vier von zwölf Hypothesen änderte sich die Einschätzung durch die Gegenprüfung deutlich. Widersprüche zwischen den Modellen waren ein zuverlässiger Hinweis darauf, wo ich genauer hinschauen musste. Seitdem bekommt jede Hypothese eine Bewertung: gut belegt, plausibel oder spekulativ.
Test 6: Die Gesprächseinstiege
Zum Schluss sollte Perplexity aus dem Dossier Gesprächseinstiege pro Rolle ableiten.
Wo es gehakt hat: Die ersten Vorschläge klangen nach Recherchebericht. „Laut Ihrem Geschäftsbericht planen Sie…“ wirkt eher wie Überwachung als wie Interesse.
Was ich angepasst habe: Einstiege über Branchenbeobachtungen und offene Fragen. Das Wissen aus dem Dossier fließt ein, wird aber nicht zitiert. Spekulative Hypothesen werden grundsätzlich als Frage formuliert, nie als Feststellung.
Was kann Perplexity im ABM, und was nicht?
| Stärke | Schwäche |
|---|---|
| Schnelle Verdichtung öffentlicher Quellen | Wenig Substanz bei Mittelständlern |
| Nachvollziehbare Quellenangaben | Verwechslung von Konzerngesellschaften |
| Gute Ableitung von Rollen und Interessen | Veraltete Personenangaben |
| Planfreigabe als starkes Kontrollinstrument | Neigung, Hypothesen zu bestätigen |
Die wichtigste Erkenntnis: Perplexity ersetzt keine Account-Kenntnis. Die Recherche liefert die öffentliche Seite eines Unternehmens. Die nicht öffentliche Seite, also Beziehungen, frühere Gespräche und interne Konstellationen, kann nur ein Mensch ergänzen.
Wie würde ich daraus im Unternehmen einen agentischen Workflow bauen?
Ab hier verlasse ich den Praxistest. Alles Folgende habe ich nicht umgesetzt, weil es echte Unternehmenssysteme und echte Daten braucht.
Mein Grundprinzip: jedes Tool für das, was es am besten kann, und an jeder kritischen Stelle ein menschliches Gate. Warum das bei KI-Agenten keine Nebensache ist, habe ich im Realismus-Check zu Chancen, Risiken und Grenzen beschrieben.
Die Rollenverteilung
Perplexity für die Recherche. Signal-Scan als geplante Aufgabe, Tiefenrecherche mit Planfreigabe, Dossiers nach fester Vorlage. Hier würde sich gegenüber meinem Test wenig ändern, außer dem Tarif: Im Unternehmen gehört das in einen Enterprise-Account.
Claude für die Qualitätsprüfung. In einem Claude-Projekt lägen Rechercheregeln, Glossar und Referenzfälle. Claude würde jedes Dossier prüfen, bevor ein Mensch es sieht: Stimmen Quellenalter und Gesellschaft? Hat jede Hypothese eine Bewertung? Sind die Fachbegriffe korrekt? Fehlerhafte Dossiers gingen automatisch zurück.
ChatGPT für Messaging und Enablement. Ein Custom GPT, der Produkt, Referenzen und Tonalität kennt, würde aus freigegebenen Dossiers rollenspezifische Botschaften und Gesprächsleitfäden erstellen.
n8n für die Orchestrierung. n8n würde die Schritte verbinden und an jeder Freigabestelle anhalten, bis ein Mensch entschieden hat.
HubSpot als Gedächtnis und Steuerzentrale. Hier würde alles zusammenlaufen. Darauf gehe ich genauer ein, weil HubSpot im Unternehmen das Herzstück wäre.
Wie würde die Recherche in HubSpot landen?
Zielaccounts und Tiers. Jeder Account bekäme die Markierung als Target Account und eine Einstufung im ICP-Tier. Tier 1 für die großen Hersteller mit individueller Betreuung, Tier 2 für Zulieferer in Clustern, Tier 3 für Accounts, die erst beobachtet werden.
Die Dossiers als Properties. Statt Dossiers nur als Dokument abzulegen, würden die Kernaussagen in eigenen Company-Properties landen: letztes Signal, Signalstärke, Datum der Recherche, die wichtigsten Hypothesen mit Bewertung und ein Link zum vollständigen Dossier. Der Vertrieb sähe auf einen Blick, was los ist.
Das Buying Center. HubSpot bringt Standardrollen wie Decision Maker, Budget Holder oder Champion mit. Für die Luft- und Raumfahrt würde ich sie um Rollen wie Qualität und Zulassung oder Programmleitung erweitern. Konkrete Personen legt der Account-Owner an, sobald er sie tatsächlich kennt.
Wo sitzt das menschliche Gate?
n8n würde die Rechercheergebnisse zunächst nur als Vorschlag in HubSpot schreiben. Erst wenn der Account-Owner das Dossier geprüft und das Feld „Dossier freigegeben“ auf Ja gesetzt hat, passiert der Rest.
Ein HubSpot-Workflow würde auf diese Freigabe reagieren: Tier aktualisieren, Account in die passenden Segmente aufnehmen, alles Weitere anstoßen. Keine Freigabe, keine Kampagne.
Ein zweites Feld „Dossier korrigiert: Ja/Nein“ würde nebenbei messen, wie oft der Mensch eingreifen muss. Diese Zahl entscheidet später darüber, wie viel Autonomie der Workflow bekommt.
Vom Dossier zur LinkedIn-Kampagne
Freigegebene Tier-1- und Tier-2-Accounts würden automatisch in Company-Segmente fließen, die HubSpot mit LinkedIn synchronisiert. Ändert sich das Tier, ändert sich die Zielgruppe der Kampagne, ohne dass jemand Listen hochladen muss.
Parallel ließen sich die Segmente für Smart Content auf der Website nutzen. Wer von einem Triebwerkshersteller kommt, sähe andere Referenzen als jemand von einem Instandhaltungsbetrieb.
Der Account-Score
Hier träfen Recherche und Verhalten zusammen. Ein eigener Score auf Company-Ebene würde die Signalstärke aus Perplexity mit dem Engagement in HubSpot kombinieren: Seitenaufrufe, Interaktionen mit LinkedIn-Anzeigen, Reaktionen auf Inhalte.
Ein Signal allein reicht nicht. Ein neuer Leiter Qualität bei einem Zulieferer ist interessant. Besuchen danach drei Personen aus diesem Unternehmen die Seiten zu Audit-Nachweisen, ist es ein Anlass.
Über einem Schwellenwert würde HubSpot eine Aufgabe für den Account-Owner erzeugen, inklusive kurzem „Warum jetzt“-Briefing. Ob daraus ein Gespräch wird, entscheidet der Mensch.
Der Workflow mit seinen Gates
| Schritt | Tool | Menschliches Gate |
|---|---|---|
| Signal erkennen | Perplexity | Wochenreview: Welche Accounts werden recherchiert? |
| Rechercheplan | Perplexity | Freigabe des Plans |
| Dossier erstellen | Perplexity | keins, Prüfung folgt |
| Qualitätsprüfung | Claude | keins, Rückgabe bei Fehlern |
| Übertragung als Vorschlag | n8n | keins, Daten landen nur als Entwurf |
| Fachliche Freigabe | HubSpot | Account-Owner setzt „Dossier freigegeben“ |
| Tier und Segmente | HubSpot | wird erst durch die Freigabe ausgelöst |
| Messaging | ChatGPT | Freigabe von Tonalität und Claims |
| LinkedIn-Zielgruppen | HubSpot | Budgetfreigabe durch Marketing |
| Account-Score und Übergabe | HubSpot | Account-Owner entscheidet über Kontakt |
| Kundenansprache | Mensch | bleibt immer menschlich |
Wann dürfte der Agent mehr Verantwortung bekommen?
Autonomie sollte nicht nach Bauchgefühl wachsen, sondern nach Daten. Meine Regel wäre: Ein Gate wird von der Einzelfreigabe auf Stichproben umgestellt, wenn über acht Wochen weniger als etwa zehn Prozent der Dossiers korrigiert werden mussten. Das Korrekturfeld in HubSpot liefert genau diese Zahl. Steigt die Quote wieder, geht das Gate zurück.
Zwei Dinge blieben dauerhaft beim Menschen: die Regeln, nach denen die Agenten arbeiten, und der direkte Kontakt zum Kunden. In einer Branche, in der Vertrauen über Jahre wächst, ist das keine Vorsicht, sondern Voraussetzung.
Du willst wissen, wo du mit KI-Agenten in deinem Marketing stehst? Der Agent-o-Meter zeigt dir in zwei Minuten, welcher Orchestrierungs-Typ du bist.
Mein Takeaway
KI-Recherche macht Account-Based Marketing nicht automatisch. Sie macht es skalierbar.
Aus einem halben Tag Recherche pro Account wurden in meinem Test rund 45 Minuten, inklusive Prüfung. Im Unternehmen würde diese Zeit dahin fließen, wo sie im ABM den Unterschied macht: in bessere Gespräche.
Was ich hier bewerte, bewerte ich aus über 15 Jahren B2B-Marketing in der IT- und Technologiebranche, nicht aus einem Tool-Test heraus.
Häufige Fragen
Was ist der Unterschied zwischen Account-Based Marketing und Lead Generation?
Lead Generation startet breit und filtert aus vielen Kontakten die passenden heraus. Account-Based Marketing startet mit einer festen Liste von Zielunternehmen und spricht diese gezielt an. ABM misst Erfolg am Engagement im Account und an gewonnenen Deals, nicht an der Zahl der Leads.
Für welche Unternehmen lohnt sich ABM?
Für Unternehmen mit überschaubar vielen möglichen Kunden, hohen Auftragswerten und komplexen Kaufentscheidungen. Bei vielen kleinen Deals in einem breiten Markt ist klassische Lead- und Demand-Generation meist effizienter.
Kann Perplexity die ABM-Recherche komplett übernehmen?
Nein. Perplexity verdichtet öffentliche Informationen schnell und mit Quellen. Schwach ist es bei wenig präsenten Mittelständlern, bei Konzernverflechtungen und bei aktuellen Personenangaben. Die nicht öffentliche Seite eines Accounts kann nur ein Mensch ergänzen.
Welchen Perplexity-Tarif braucht man für ABM-Recherche?
Für einen privaten Test reicht Pro. Spaces, Deep Research und geplante Aufgaben sind enthalten, Model Council läuft über Perplexity Computer und verbraucht Credits. Im Unternehmen gehört die Recherche in einen Enterprise-Tarif. Enterprise Max enthält den Council mit monatlichem Kontingent, und nur die Enterprise-Tarife schließen das Training mit euren Daten aus.
Wie prüfe ich, ob die Rechercheergebnisse stimmen?
Mit einem regelmäßigen Kontrollabgleich. Ich habe Personen- und Unternehmensangaben stichprobenartig auf LinkedIn gegengeprüft und jede Bedarfshypothese zusätzlich kritisch gegenfragen lassen. Widersprüche zwischen den Modellen im Model Council zeigen zuverlässig, wo du genauer hinschauen musst.