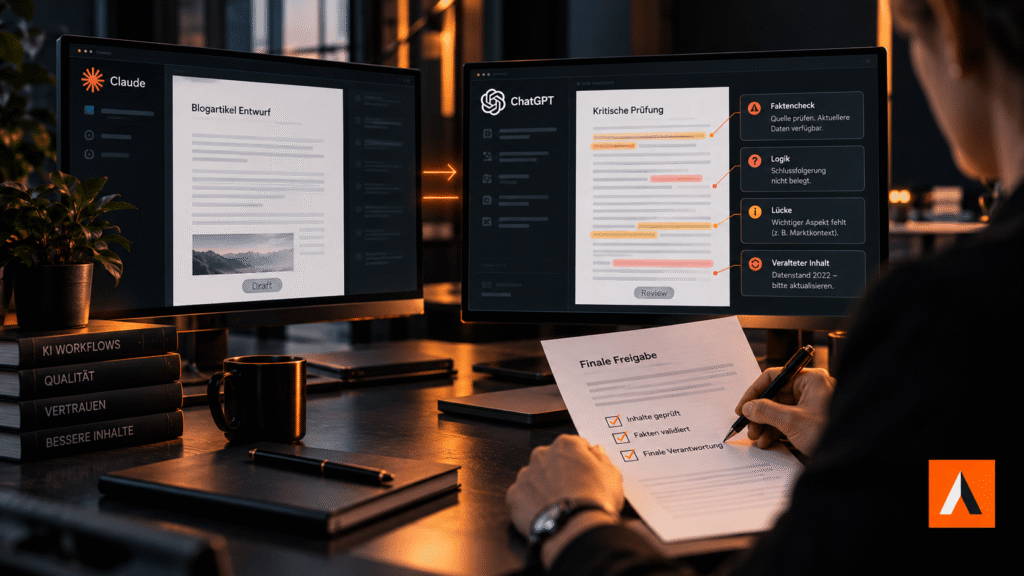
Kurz gefasst. KI-Ergebnisse zu prüfen wird zur wichtigsten KI-Kompetenz, weil Sprachmodelle dazu neigen, uns zu gefallen. Beim Vier-Augen-Prinzip für KI prüft ein zweites Modell eines anderen Anbieters die Arbeit des ersten, etwa ChatGPT die Texte von Claude. Am einfachsten geht das per Prüf-Prompt, automatisiert über MCP. Die letzte Freigabe bleibt beim Menschen.
Die wichtigste KI-Kompetenz der nächsten Jahre ist nicht das Prompten. Es ist das Prüfen.
Kennst du das? Du lässt dir von der KI einen Entwurf schreiben, fragst nach Feedback und bekommst: „Das ist ein hervorragender Text!“ Fühlt sich gut an. Hilft dir aber kein Stück weiter.
Genau hier setzt das Vier-Augen-Prinzip für KI an. Die Idee kennst du aus jeder Buchhaltung: Niemand gibt seine eigene Arbeit frei. Übertragen auf KI heißt das: Ein zweites Sprachmodell von einem anderen Anbieter prüft, was das erste geliefert hat.
Wobei: Bei KI reichen vier Augen nicht. Du brauchst sechs.
Im KI-Marketing wird das gerade vom Nice-to-have zur Pflicht. Warum das so ist und wie du Claude und ChatGPT ganz praktisch gegeneinander antreten lässt, zeige ich dir in diesem Artikel.
Was ist das Vier-Augen-Prinzip für KI?
Beim Vier-Augen-Prinzip für KI prüft ein zweites Sprachmodell eines anderen Anbieters das Ergebnis des ersten Modells, bevor ein Mensch es freigibt. Ziel ist, Fehler, Lücken und Schönfärberei zu finden, die das erste Modell selbst übersieht.
Das Prinzip ist alt. In Unternehmen unterschreibt bei Überweisungen, Verträgen oder Freigaben nie nur eine Person. Der Grund ist simpel: Wer etwas selbst erstellt hat, sieht die eigenen Fehler am schlechtesten.
Bei KI ist das nicht anders. Ein Modell, das seinen eigenen Text bewerten soll, ist Autor und Prüfer zugleich. Das kann nicht gut gehen.
Warum ist KI so oft zu nett?
Sprachmodelle neigen dazu, Nutzern zuzustimmen und sie zu loben, weil sie unter anderem mit menschlichem Feedback trainiert werden. Menschen bewerten Zustimmung lieber als Widerspruch. In der Forschung heißt dieses Verhalten Sycophancy, auf Deutsch etwa Gefallsucht.
Wie real das Problem ist, hat OpenAI selbst gezeigt. Im April 2025 hat das Unternehmen ein GPT‑4o-Update in ChatGPT zurückgenommen, weil das Modell übermäßig schmeichelnd und zustimmend geworden war.
Die Begründung ist spannend: OpenAI hatte sich nach eigener Aussage zu stark auf kurzfristiges Feedback wie Daumen hoch oder runter gestützt. Das Ergebnis waren übertrieben unterstützende, aber unaufrichtige Antworten.
Seitdem haben alle Anbieter nachgebessert. Die Grundtendenz bleibt aber:
Eine KI, die dir gefallen will, ist ein schlechter Lektor.
Warum findet ein zweites Modell mehr Fehler als die Selbstkontrolle?
Modelle verschiedener Anbieter werden mit unterschiedlichen Daten und Methoden trainiert und machen deshalb unterschiedliche Fehler. Was Claude übersieht, fällt ChatGPT oft auf und umgekehrt.
In der Softwareentwicklung wird das längst genutzt. In einem Open-Source-Projekt rund um Code-Reviews heißt es sinngemäß: Modelle unterschiedlicher Anbieter haben weitgehend unabhängige Fehlermuster, deshalb findet ein Review durch ein anderes Modell Probleme, die die Selbstprüfung übersieht.
Auch der Markt bewegt sich in diese Richtung. Perplexity hat im Februar 2026 Model Council gestartet: Eine Frage geht gleichzeitig an drei Modelle, ein Synthesizer vergleicht die Antworten danach in einer Tabelle. Microsoft geht in Copilot einen ähnlichen Weg und lässt Claude die Arbeit von GPT prüfen.
Die Logik dahinter ist einfach: Kommen die Modelle zum selben Ergebnis, kannst du schneller handeln. Weichen sie voneinander ab, ist das ein Signal, genauer hinzuschauen.
Warum ist KI-Prüfung ein Future Skill?
KI-Prüfung ist ein Future Skill, weil KI immer mehr Inhalte erstellt, die Verantwortung dafür aber beim Menschen bleibt. Wer KI-Output nicht kritisch bewerten kann, veröffentlicht früher oder später Fehler unter eigenem Namen.
Prompten lernt man in ein paar Wochen. Gutes Prüfen braucht Fachwissen, Erfahrung und einen klaren Blick dafür, was fehlt.
Diese sechs Punkte solltest du bei jedem KI-Ergebnis abklopfen:
- FaktenStimmt das, und kann ich es belegen?
- QuellenGibt es die Quelle wirklich, und sagt sie das?
- LogikPasst die Argumentation zusammen?
- LückenWas fehlt, das meine Zielgruppe wissen muss?
- TonalitätKlingt das nach uns oder nach Standard-KI?
- AktualitätIst das noch der Stand von heute?
Ein zweites Modell kann dir bei allen sechs Punkten helfen. Die Entscheidung nimmt es dir nicht ab.
Warum wird das bei KI-Agenten noch wichtiger?
Bei KI-Agenten muss die Prüfung fest in den Ablauf eingebaut sein, weil Agenten Aufgaben eigenständig und in mehreren Schritten erledigen. Niemand schaut bei jedem Zwischenschritt über die Schulter.
Genau das ist der Kern von Agentic Marketing: Agenten recherchieren, schreiben, planen und veröffentlichen zunehmend selbst. Ein Fehler in Schritt zwei zieht sich dann durch alle folgenden Schritte.
Deshalb tauchen in Agentic-Workflows immer öfter sogenannte Review-Gates auf. Das sind feste Prüfpunkte, an denen ein zweites Modell die Arbeit des ersten automatisch bewertet, bevor es weitergeht. Für mich ist das einer der spannendsten Bausteine im Agentic AI Marketing: Qualitätssicherung als Teil des Prozesses statt als Feuerwehreinsatz am Ende.
Wie weit ist dein Marketing schon auf dem Weg zu KI-Agenten?
Agent-o-Meter startenDauert rund zwei Minuten
Wie verbinde ich Claude und ChatGPT?
Claude und ChatGPT lassen sich auf drei Wegen gegenseitig prüfen: manuell per Prüf-Prompt, mit Claude als Zentrale über MCP oder mit ChatGPT als Zentrale über den Developer Mode. Der Aufwand steigt dabei deutlich.
MCP steht für Model Context Protocol. Das ist ein offener Standard, über den KI-Modelle mit externen Tools und Diensten sprechen können, also auch mit anderen KI-Modellen.
| Weg | Aufwand | Voraussetzung | Für wen |
|---|---|---|---|
| Manuell mit Prüf-Prompt | gering | Zugang zu beiden Tools | alle |
| Claude als Zentrale (MCP) | mittel | Claude Desktop oder Claude Code, OpenAI-Zugang | Technikaffine |
| ChatGPT als Zentrale (MCP) | hoch | Developer Mode, eigener MCP-Server | Teams mit Entwicklung |
Weg 1: Manuell mit Prüf-Prompt
Du lässt Claude den Text schreiben, kopierst ihn in ChatGPT und gibst einen klaren Prüfauftrag mit. Danach gehst du mit der Kritik zurück zu Claude. Das funktioniert auch andersherum.
Klingt unspektakulär, ist aber für die meisten der beste Einstieg. Kein Setup, keine Kosten, volle Kontrolle. Die Vorlage für den Prompt findest du weiter unten.
Weg 2: Claude als Zentrale per MCP
Hier ruft Claude ChatGPT direkt auf, ganz ohne Copy-Paste. Dafür gibt es inzwischen mehrere Community-Lösungen, etwa einen MCP-Server, über den Claude ChatGPT, Perplexity oder Gemini zur Verifikation befragt.
OpenAI hat sogar selbst ein Plugin für Claude Code veröffentlicht. Es bietet Standard- und „adversarial“ Reviews und setzt ein ChatGPT-Abo (auch Free) oder einen OpenAI-API-Key voraus. Das Plugin ist für Code gedacht, zeigt aber, wohin die Reise geht: Selbst die Anbieter sehen den Wert der gegenseitigen Prüfung.
Der Haken: Diese Lösungen laufen über Claude Desktop oder Claude Code und brauchen eine technische Einrichtung.
Weg 3: ChatGPT als Zentrale
Auch ChatGPT kann über MCP externe Dienste ansprechen. Die Rechte hängen aber vom Tarif ab: Volle MCP-Unterstützung mit Schreibrechten gibt es in Business, Enterprise und Education. Plus- und Pro-Nutzer können eigene MCP-Server nur lesend im Developer Mode anbinden.
Zusätzlich verbindet sich ChatGPT nur mit Remote-MCP-Servern über das öffentliche Internet. Du bräuchtest also einen eigenen, gehosteten Server, der Claude anspricht. Eine fertige Lösung von der Stange gibt es dafür bisher kaum.
Mehr als zwei Modelle
Wer gleich einen ganzen Rat befragen will, hat zwei Optionen:
- Perplexity Model Council: drei Modelle parallel, Vergleich in einer Tabelle. Aktuell nur für Perplexity-Max-Abonnenten verfügbar.
- LLM Council von Andrej Karpathy: Ein Open-Source-Projekt, bei dem jedes Modell die Antworten der anderen anonym nach Genauigkeit und Erkenntnisgewinn bewertet. Ein „Chairman“-Modell führt am Ende alles zusammen.
Was ist der wichtigste Trick beim gegenseitigen Prüfen?
Der wichtigste Trick ist, dem prüfenden Modell nicht zu verraten, von welcher KI der Text stammt. Sonst bewertet es nicht den Inhalt, sondern den Absender.
Andrej Karpathy, Mitgründer von OpenAI, hat genau das beim Testen seines LLM Council beobachtet. Sobald konkurrierende Modelle erfuhren, dass eine Antwort von GPT stammt, knickten sie laut Karpathy sofort ein und begannen, sich selbst zu korrigieren.
Für dich heißt das: Schreib nie „Das hat Claude geschrieben, was meinst du?“. Gib den Text neutral weiter. Am besten so, als hätte ihn ein Kollege verfasst, dessen Arbeit du vor der Freigabe prüfen musst.
Vorlage: Prüf-Prompt zum Kopieren
Dieser Prompt funktioniert in Claude und ChatGPT gleichermaßen:
Du bist ein kritischer Lektor und Faktenprüfer. Prüfe den folgenden Text, als müsstest du ihn vor der Veröffentlichung freigeben. Wer ihn geschrieben hat, ist nicht bekannt.

Prüfe auf:
1. Sachliche Fehler und unbelegte Behauptungen
2. Zahlen und Quellen, die du nicht nachvollziehen kannst
3. Logische Brüche und Widersprüche
4. Wichtige Aspekte, die fehlen
5. Formulierungen, die nicht zur Zielgruppe [Zielgruppe einsetzen] passen
6. Aussagen, die veraltet sein könnten

Gib das Ergebnis als Liste aus: Problem, Fundstelle, Verbesserungsvorschlag. Kein Lob, keine Zusammenfassung. Wenn du nichts findest, begründe, warum der Text aus deiner Sicht belastbar ist.

Text:
[Text einfügen]
Zwei Details machen hier den Unterschied. „Kein Lob“ nimmt der KI die Möglichkeit, sich in Komplimente zu retten. „Begründe, wenn du nichts findest“ verhindert ein bequemes „Passt alles“.
Wo liegen die Grenzen?
Zwei KI-Modelle finden mehr Fehler als eines, ersetzen aber nicht die menschliche Freigabe. Am Ende bleibt die Verantwortung bei dir.
Deshalb das Sechs-Augen-Prinzip vom Anfang: zwei Modelle, ein Mensch. Die KI-Prüfung ist ein Filter, kein Freifahrtschein.
Drei Punkte solltest du im Blick behalten:
- Gemeinsame blinde Flecken: Beide Modelle können denselben Fehler machen, etwa wenn ihr Wissen auf demselben veralteten Stand ist.
- Datenschutz: Wer Inhalte bei zwei Anbietern verarbeiten lässt, gibt Daten an zwei Dienstleister. Kundendaten und Vertrauliches haben in diesem Workflow nichts verloren, solange das nicht sauber geregelt ist.
- Aufwand: Nicht jeder Social-Post braucht eine Doppelprüfung. Sinnvoll ist das Prinzip vor allem bei Fachartikeln, Zahlen, Whitepapern und allem, was dauerhaft öffentlich steht.
Häufige Fragen
Kann ChatGPT die Antworten von Claude prüfen?
Ja, ChatGPT kann Texte von Claude prüfen und umgekehrt. Am einfachsten geht das per Copy-Paste mit einem klaren Prüf-Prompt. Automatisiert funktioniert es über MCP, braucht dann aber eine technische Einrichtung.
Brauche ich Programmierkenntnisse für das Vier-Augen-Prinzip mit KI?
Nein, für den manuellen Weg brauchst du nur Zugang zu zwei KI-Tools und einen guten Prüf-Prompt. Programmierkenntnisse werden erst nötig, wenn du die Modelle per MCP direkt miteinander verbinden willst.
Ersetzt KI-Prüfung die menschliche Kontrolle?
Nein, KI-Prüfung ergänzt die menschliche Kontrolle, ersetzt sie aber nicht. Die Modelle finden Fehler und Lücken, die finale Entscheidung und die Verantwortung bleiben beim Menschen.
Welche Rolle spielt das Vier-Augen-Prinzip im KI-Marketing?
Im KI-Marketing sichert das Vier-Augen-Prinzip die Qualität von Inhalten, die mit KI erstellt werden. Je mehr Content und Prozesse KI übernimmt, desto wichtiger wird eine feste Prüfinstanz, besonders bei Fachinhalten und Zahlen.
Fazit
KI schreibt schneller als jeder Mensch. Prüfen muss sie trotzdem jemand. Lass Claude und ChatGPT sich gegenseitig challengen, verrate dabei nicht, wer der Absender ist, und behalte die letzte Freigabe für dich.
Du willst wissen, wie bereit dein Marketing für KI-Agenten ist?
Agent-o-Meter startenDauert rund zwei Minuten